Der Zusammenhang.
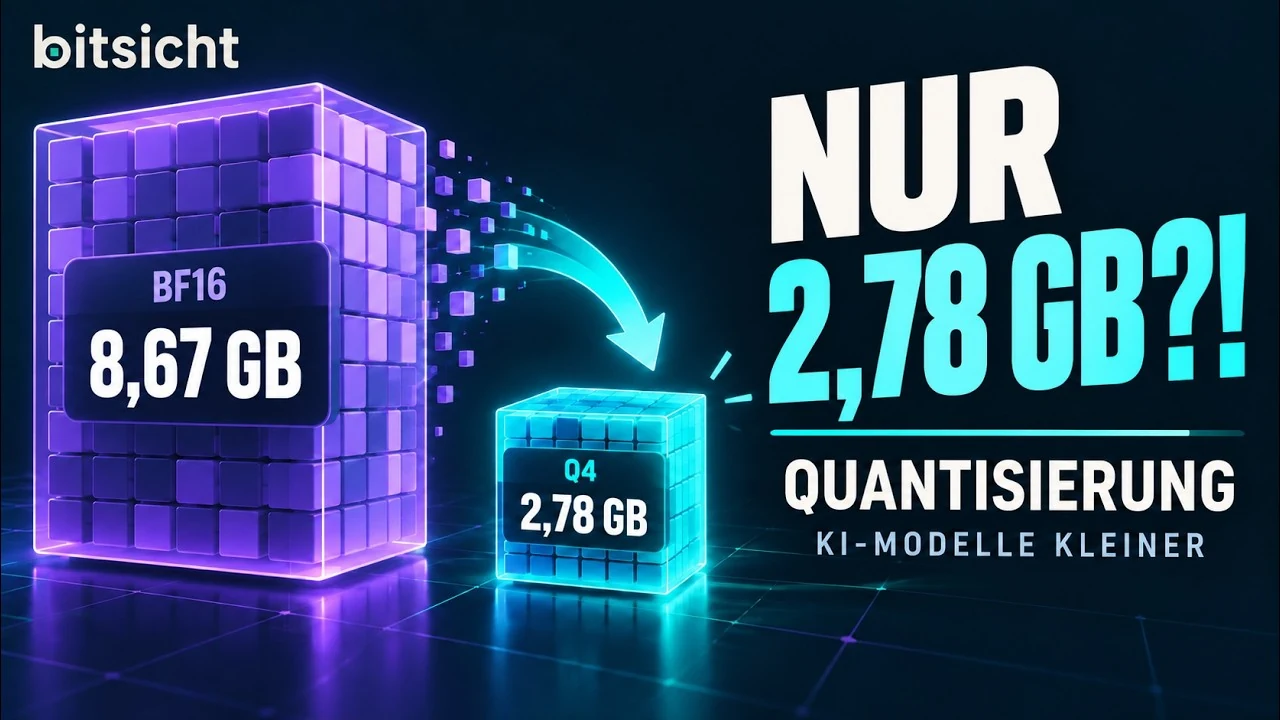
Quantisierung speichert gelernte Gewichte mit weniger Bits und nähert ihre Werte dabei numerisch an. Das Video verbindet einfache Zahlenbeispiele mit drei echten Qwen3.5-4B-Dateien. Es erklärt, weshalb weniger Dateispeicher weder automatisch genügend Arbeitsspeicher noch mehr Tempo oder gleichbleibende Qualität bedeutet.
Lernziele
- Gewichte, Parameteranzahl und ihre numerische Darstellung unterscheiden.
- Dateigröße vom gesamten Speicherbedarf einer laufenden KI trennen.
- Speicherersparnis, mögliche Geschwindigkeitsvorteile und Qualitätskosten gemeinsam einordnen.
Weniger Bits für dieselben Parameter
Architektur und Parameteranzahl bleiben bei der gezeigten Quantisierung erhalten. Verändert wird die Darstellung der Gewichtswerte. Skalen und Blöcke helfen dabei, den verfügbaren Zahlenbereich zu nutzen; die Werte sind anschließend Näherungen.
Drei Dateien, ein konkretes Beispiel
Für den gezeigten Qwen3.5-4B-Vergleich nennt das Video 8,67 GB für BF16, 4,61 GB für Q8_0 und 2,78 GB für Q4_K_M. Das sind Dateigrößen dieser Fassungen. Zum Betrieb kommen weitere Speicheranteile hinzu; die Werte sind keine allgemeine RAM- oder VRAM-Zusage.
Qualität und Tempo selbst prüfen
Wie sich Quantisierung auswirkt, hängt von Modell, Aufgabe, Format sowie Hardware und Software ab. Der wiederholte Quadrat-Test im Video ist ein einzelner deterministischer Testfall. Er ersetzt keinen repräsentativen Qualitätsbenchmark und belegt keinen allgemeinen Geschwindigkeitsgewinn.
Einordnung & Grenzen
Messwerte gelten für das im Video gezeigte Modell und Setup. Die Erklärung ist keine allgemeine Hardwareempfehlung oder unabhängige Benchmarkreihe.
Speicherbedarf lokaler KI nachlesen →
Quellen & Weiterlesen
Dieser Begleittext wurde anhand der öffentlichen Videobeschreibung redaktionell ausgearbeitet; er ist kein Transkript. Die folgenden Quellen sind auch im Originalvideo angegeben.